问题的背后是什么,如何想得更全面?
现在每天的生产问题,基本都是将代码、数据、生产状态等指标一股脑交给 Claude Code,让它直连对应环境去跑,基本上在半小时内,结论就到手了。
放在以前,需要一点点自己去看日志、插数据、结合代码分析,反复推翻,最终找到本质原因,才能下定论。
有了AI之后,结合本地Agent,大大的加快了解决事情的效率。我们能保留的是,告诉AI做什么,而不是告诉AI怎么做。
但每个人的思维、品味都不太一样,以至于不同的人,即使用相同的AI工具,做同一件事情,结果也会有很大的差异。
那面对同一个问题,我们如何让AI更有效的执行呢?我自己实践下来,感觉也是有一点技巧的,关键还是在于自身的功力够不够。
想全,不是把所有可能都列一遍
想全面,并不是说要有一张越拉越长的清单。
项目失败的一个原因,是很多人在规划阶段没说顾虑,放任其通过了。2010 年麦肯锡季刊的一次访谈里,说到要对一个快要拍板的计划做事前验尸,一般不会让计划被推翻,但它多半会被改得更好,而且改完所有人都认。这是低成本,高回报的操作。
第一件工具,先怀疑题目本身
比如我们的系统常被业务投诉,说太慢、说数据不准确、说不够具备分析决策意义等。
针对每类问题,我要先搞清楚是谁在投诉,这个问题导致的后果,是谁在承受,这个后果导致的难受会不会随着时间推进而消失,如果我不处理这个问题会有什么后果。
这些问题在内心盘算一遍,很多业务问题根本就不是问题。
这个动作有个正式的名字,叫问题重构。
Thomas Wedell-Wedellsborg 在《哈佛商业评论》写过一篇《Are You Solving the Right Problems?》,开头是一组调查。他问了 17 个国家、91 家机构的 106 位 C 级高管,85% 认为自己的组织不擅长诊断问题,87% 认为这个毛病代价很大,说自己不受影响的不到十分之一。他的解释是,管理者天生偏爱行动,很快就切进了找方案的模式,没停下来确认自己到底弄懂了问题没有。
他常讲一个慢电梯的例子,很多地方都转述过。一栋写字楼的租户抱怨电梯太慢,楼主开始琢磨是换电机还是换整部电梯。有人给了个便宜得多的建议,在电梯旁边装几面镜子。
其实镜子不会让电梯变快。
解决方案直接将题目换掉了。问题本身可能从来不是电梯的速度,而是等待本身太难熬。
谁在痛,把视线从问题挪到人身上;会不会自己消失,判断值不值得动手;什么都不做最坏怎样,给问题定个价。我觉得这比“换位思考”好用。
第二件工具,反过来问怎样才会失败
芒格在1986 年 6 月 13 日给 Harvard School 给毕业生做演讲,演讲题目是《How to Guarantee a Life of Misery》。他没讲怎样成功,反过来讲了一整场关于怎样保证一生痛苦的事情。
这次演讲里有两句在后来广为传播。
- 要是知道自己会死在哪儿,就永远不去那儿。
- 反过来,总是反过来,很多难题只有倒着处理才解得开。
倒着问的好处,在于它绕开了一个心理上的障碍。
正着想怎样才能成,人会不自觉地挑对自己有利的路径。倒过来想怎样保证搞砸,那些平时不愿细想的坑,反而会冒出来。 KPI 和 OKR 会把人训练得只往成功的方向推演,倒着问,就是给这种惯性纠偏。
其实这个工具用起来也不复杂。方案评审前多加一问,怎样做能保证这件事一定搞砸,把答案一条条写下来,再回头校验自己的方案。
第三件工具,把失败说成已经发生
Gary Klein 是研究人在真实环境里怎么做决策的心理学家。他在《哈佛商业评论》发了一篇很短的文章,《Performing a Project Premortem》。
文章里举了个例子。一个给军方空战规划人员做算法的项目,有位成员在此前冗长的启动会上一句话没说,到了事前核验时才开口。其中一个算法装不进野外用的某些笔记本电脑,一跑就是好几个小时,而用户要的是马上出结果。当时算法开发者其实已经知道了问题,只是一直没好意思提,后来换上之后,项目很成功。
Klein 后来在麦肯锡的访谈里说到事前验尸是个狡猾的办法,能让人做唱反调式的思考,却不会遭到抵抗。
事前验尸好使,靠的不是把自己放到一年后,而是用确定的口气宣布它死了。主持人如果说大家想想这个项目可能出什么问题,那就退回了普通的风险评审。
一场事前验尸的行动,拿到了一张更长的核验清单,最终由人来判断哪几条是致命的。
这一步交给 AI,要先防两件事
读到这里你大概已经发现,事前验尸和今天的大模型有一种天然的契合。
它要的是在短时间里想出尽可能多的失败理由,而大模型最便宜的,恰恰是生成候选。它也没有人在会议室里的那些顾虑,不怕得罪项目负责人,不担心被当成乌鸦嘴。每天让 Claude 直连环境跑分析,在跑之前,告诉 Claude 这个方案已经失败,列出二十条失败的原因,几乎不花什么成本。
那是不是把事前验尸整个丢给 AI 就够了?
不够。这里仍有两个问题。
第一个坑,模型默认倾向于顺着你说。
现在语言模型仍然过于迎合倾向。如果你问 AI 我这个方案怎么样,大概率会收获一堆鼓励。事前验尸的问法正好绕开这一点,它不问方案好不好,直接宣布方案已经死了,要AI分析这个方案的死因。
第二个坑,AI 看不到组织里的事。
比如政策更改、会议的时间限制、上下级关系、人情世故,这些都不在AI的范畴里面。
所以我觉得比较合理的分工是,AI 负责多,人最终仍需要拍板准确性。
曾经普渡大学的几位研究者在 2024 年的 IUI 会议上发过一篇论文,大概能看到这种分工的样子,用 GPT-3.5-turbo 做了几种魔鬼代言人,让 350 名受试者分组做一组风险预测,配给他们的 AI 模型是用有偏的数据训练的。结果是,专门反对 AI 建议的那种魔鬼代言人,有潜力让小组更恰当地依赖 AI,既不盲从,也不全盘否定;能和人来回对话的版本,被认为更有协作感,质量也更高。
整体分工协作流程如下图所示:
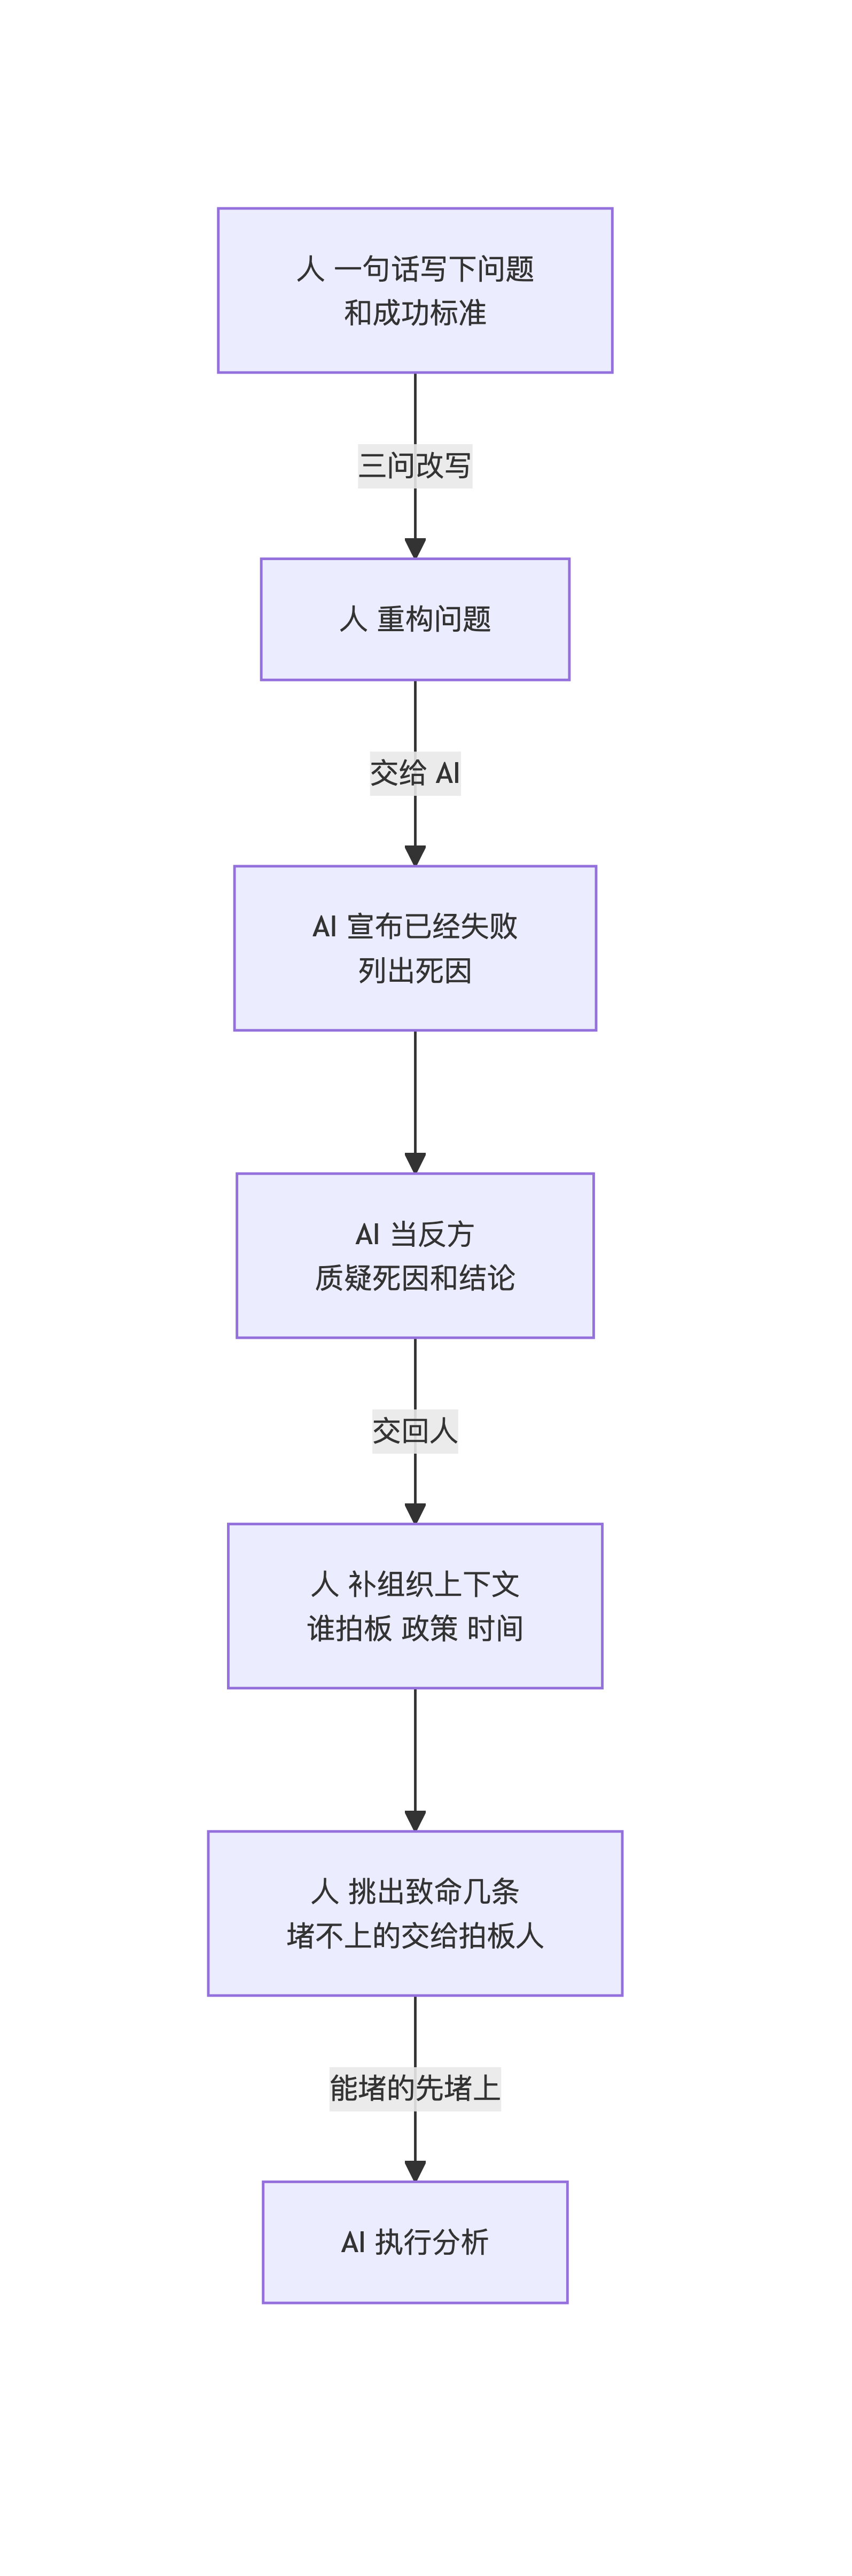
图中涉及到 AI 的两步,可以用类似下面这样的提示词起头,用的时候按自己的场景改。
假设现在是半年后,下面这个分析方案已经彻底失败了,结论被业务方推翻,团队的数据口径不再被信任。
不要评价方案的优点。请用已经发生的口吻,列出导致失败的 15 个具体原因,按致命程度排序。
然后换一个角色,作为最挑剔的反对者,逐条质疑你刚才给出的前三条,指出哪些是你的推测,在我给你的材料里找不到依据。

方案如下
(粘贴问题陈述、口径定义和分析思路)
AI 列出来的东西,接下来要进到图里的后两步,由人补上上下文,挑出致命的那几条。
最后
本文开头提到的半小时解决问题的场景,Claude 连接环境分析,然后归因,最终给问题回复写话术。
按这篇的思路回顾一遍。我们先用三问把题目改写一遍,确认要修的真正问题;再让 AI 宣布这个分析已经失败,列一串本质原因是啥;最后我们再来补上那些不在数据里的东西,谁在业务方面前被质疑,谁有权拍板。
这三件事,第一件和最后一件,现在还只能人来做。
中间那件,交给 AI也许比交给那群怕得罪人的同事更合适。
把问题想得更全这件事情,交给机器比我们自己做更合适,它更擅长替我们多想;但把问题问对是交不出去的;以及认出真正致命的那几条,AI 也替我们搞不定。